Una idea técnica por vídeo. El artículo completo a un clic.
Explora las 76 explicaciones publicadas en 5sigmas. Cada página de vídeo incluye un resumen, ideas clave, el capítulo original y el siguiente contenido recomendado.
76 vídeos disponibles
 2:12
Datos, permisos y consecuencias
Leer correctamente una instrucción no le concede autoridad para cambiar los permisos.
1. Prompt injection visual · 2. Fugas de sistema y manipulación de herramientas 2:14
Medir capacidades distintas
IoU vale cero coma seis: reconocer la clase no habría medido este error de localización.
1. Qué significa evaluar el grounding · 2. El problema de la contaminación de benchmarks 2:12
Conectar representaciones y modelos
Ese sistema devuelve un registro; para redactar una respuesta hace falta una etapa generativa aparte.
1. Encoder visual + conector + modelo de lenguaje · 2. Fusión mediante cross-attention 2:11
Aprender alineamiento
El objetivo distingue los pares del lote; no garantiza que todas las etiquetas sean correctas.
1. Pares imagen-texto: la base y sus límites · 2. Más allá del par: alineamiento de múltiples modalidades 2:13
Estructura, resolución y tiempo
Si esa posición resolvía la pregunta, la reducción ya eliminó la evidencia necesaria.
1. Una modalidad no es solo un tipo de input · 2. El problema no es añadir modalidades, sino cruzarlas sin destruirlas 2:10
Conservar evidencia entre modalidades
Esa descripción perdió una relación espacial necesaria para responder dónde está cada objeto.
1. El problema real: qué cuenta como multimodalidad · 2. Alineamiento: de pares a interacciones 2:15
Medir el sistema completo
Son experimentos diferentes: el segundo puede reducir las llegadas justo cuando aumenta la latencia.
Un benchmark es un protocolo, no un escalar · El workload debe parecerse al problema que quieres resolver 2:14
Decidir bajo restricciones
La selección optimiza dentro del conjunto permitido. Una alternativa barata pero incompatible no es una opción válida.
La política empieza por lo que no puede elegir · Model routing elige antes del primer intento 2:15
Prefix caching vs speculative decoding
La continuación todavía debe generarse. Un hit de prefijo no recupera una respuesta completa.
El presupuesto de latencia vuelve a ser el punto de partida · Prefix caching reutiliza estado de un prefijo ya calculado 2:15
Precisión y distribución
El error es 0,12. Menor precisión exige evaluar la tarea, no sólo el ahorro.
Cuantización no significa que todo el modelo tenga la misma precisión · La operación básica introduce error de representación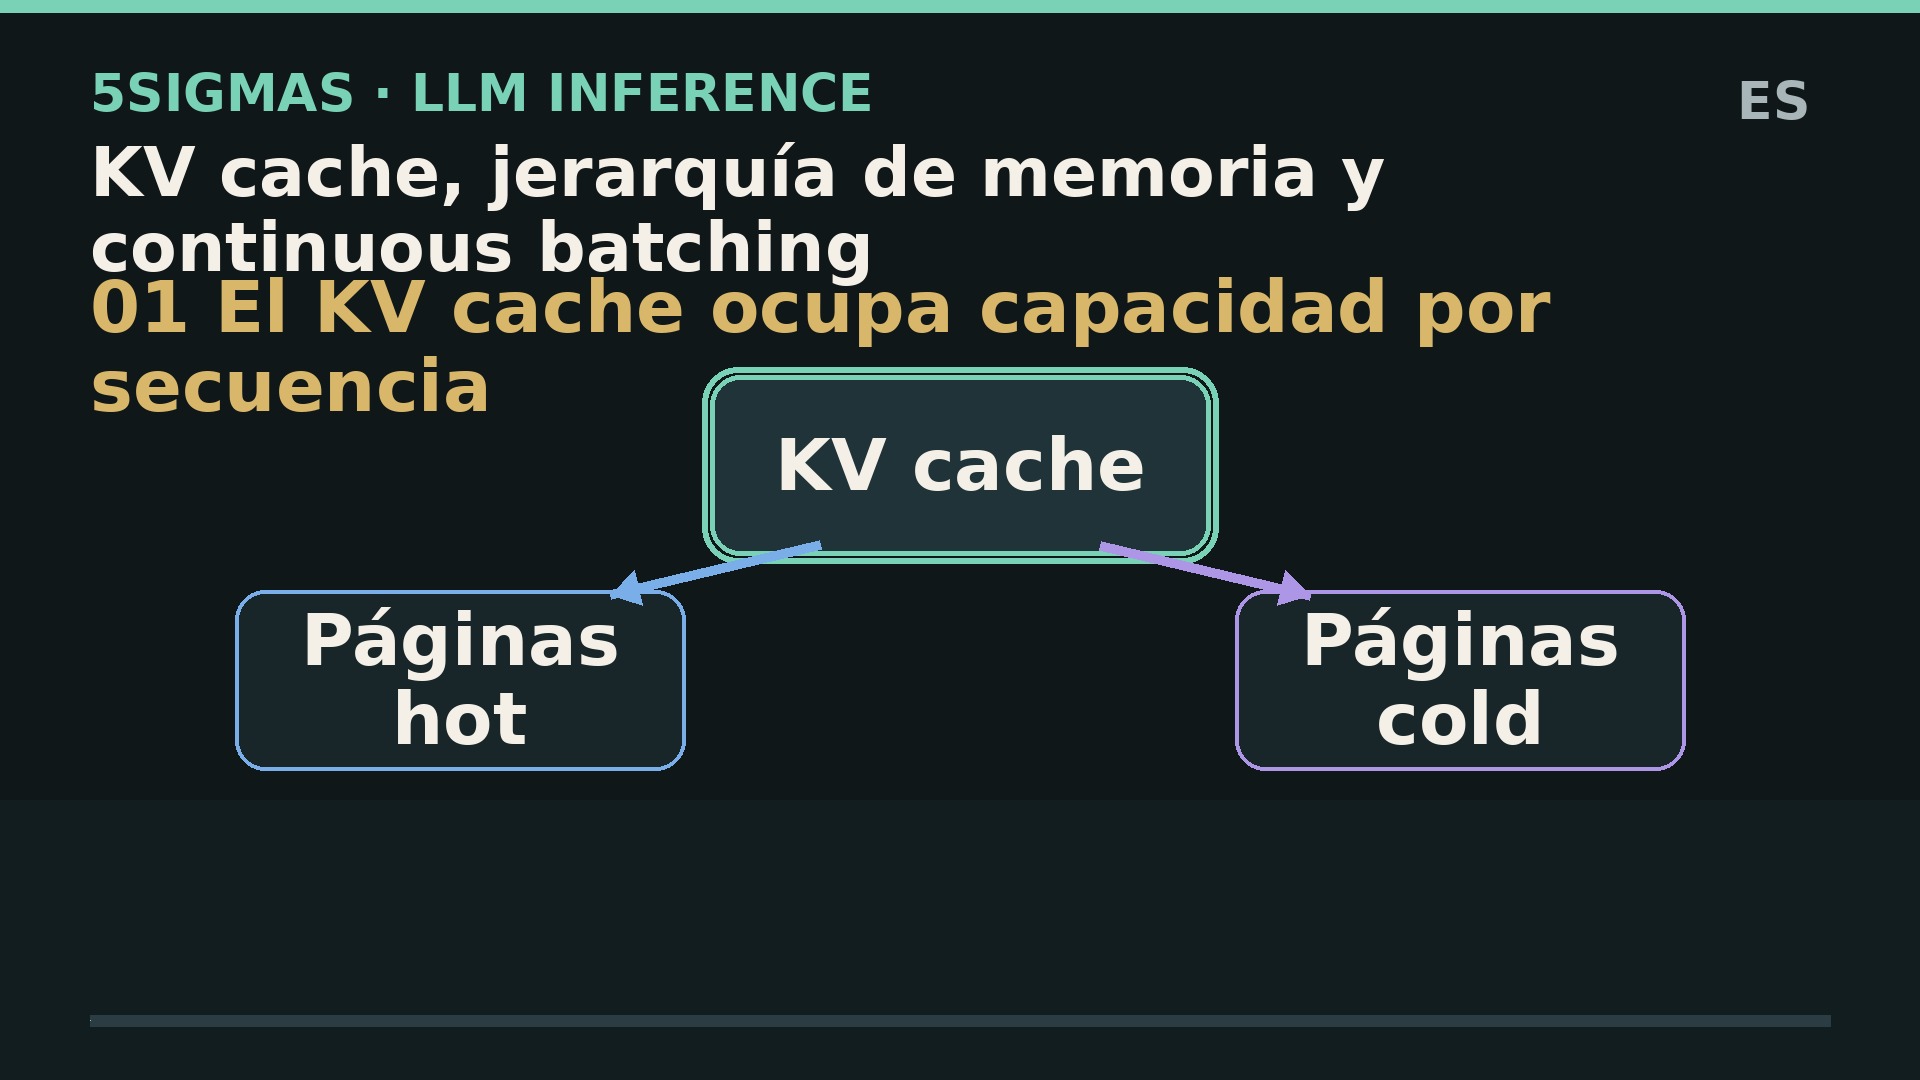 2:13
Estado y capacidad
Para 4096 tokens son 512 MiB de carga KV. No incluye pesos ni buffers.
Qué guarda realmente el KV cache · Una fórmula útil para estimar memoria — con límites explícitos 2:13
El reloj de una petición
Entrada larga y salida larga añaden trabajo en fases diferentes. Un único reloj no distingue ambas.
La petición cambia de forma después del prefill · TTFT mide una frontera visible para el cliente, no una sola operación 2:16
De la mejora de tarea al efecto agregado
El total queda en ochenta y cinco minutos: la mejora depende de la fracción realmente afectada.
1. Por qué el impacto macro tarda en llegar · Los cuatro mecanismos del desfase 2:14
Qué mide el PIB y qué deja fuera
A precios del primer periodo, el volumen pasa de cien a doscientos: distingue PIB nominal y real.
1. Qué mide el PIB y qué deja fuera · Lo que queda fuera del PIB 2:14
La IA dentro de un sistema eléctrico
Con veinte mil consultas, la inferencia suma doscientos y el total trescientos: depende del volumen.
1. Qué implica "compute" en la práctica · Entrenamiento 2:11
Electricidad y servicio efectivo
Capacidad y duración son condiciones distintas: una conexión nominal no demuestra acceso efectivo.
1. Los cuatro canales principales · Salud 2:14
Separar energía, producción y bienestar
El total diario coincide, pero no la capacidad de prestar ese servicio en su horario.
1. Electricidad → bienestar (los mecanismos reales) · 2. IA como tecnología eléctrica 2:12
Qué significa evaluar generalidad
Describe profundidad y amplitud por separado; un pico de rendimiento no cubre todo el mapa.
1. El problema de la definición · 2. Las definiciones en disputa 2:10
Elegir y evaluar una configuración
El texto fluido no sustituye la validación del riesgo ni la comprobación de sus afirmaciones.
1. Las cinco diferencias · 1.1 Entradas y salidas 2:10
Cómo se construye una respuesta generativa
La cercanía depende del modelo y la tarea; no garantiza que dos afirmaciones sean equivalentes.
1. Embeddings: Traduciendo el texto a números · 2. El Transformer: La arquitectura que lo cambia todo 2:11
Qué aprende un sistema de IA
Generar contenido describe una finalidad: las redes profundas también pueden clasificar, no sólo generar.
1. El Marco General: IA, ML, DL y GenAI · 2. ¿Cómo aprenden estos sistemas? 2:09
Un mapa que separa tareas y sistemas
La forma de la salida determina qué errores debemos medir.
1. Qué es la IA y su evolución · 2. Qué es IA generativa exactamente 2:12
Búsqueda, memoria y acción con límites
La búsqueda aporta alternativas; el verificador aporta evidencia para este criterio concreto.
1. Por qué el Transformer ya no basta como mapa completo · 1.1 Verdad, incertidumbre y alucinación 2:11
Escalar datos, cálculo y reutilización
Aprender esos filtros permite construir representaciones a partir de píxeles.
1. 2012: cuando la escala dejó de ser un detalle · 2. El Transformer y el preentrenamiento masivo 2:14
Aprender parámetros y representaciones
El mantenimiento crece cuando cambian las condiciones; automatizar una regla no resuelve todas sus excepciones.
1. La era de las reglas: cuando la inteligencia se escribía a mano · Los primeros sistemas simbólicos 2:10
Separar instrucciones, lógica y memoria
El mecanismo representa diez sin que una persona deba recordar el acarreo.
1. De automatizar cuentas a programar procedimientos · Las primeras calculadoras: automatizar no es programar 2:11
Representar cantidades, relaciones y cambio
Diez marcas siguen representando diez unidades: cambia la organización, no la cantidad.
1. Inventamos lenguajes para describir el mundo · Antes de escribir, ya contábamos 2:10
Cinco cambios en cómo tratamos información
El registro conserva la cantidad aunque los objetos ya no estén a la vista.
1. Representar (≈ 40 000 a. C. – 1700) · 2. Mecanizar (≈ 1700 – 1956)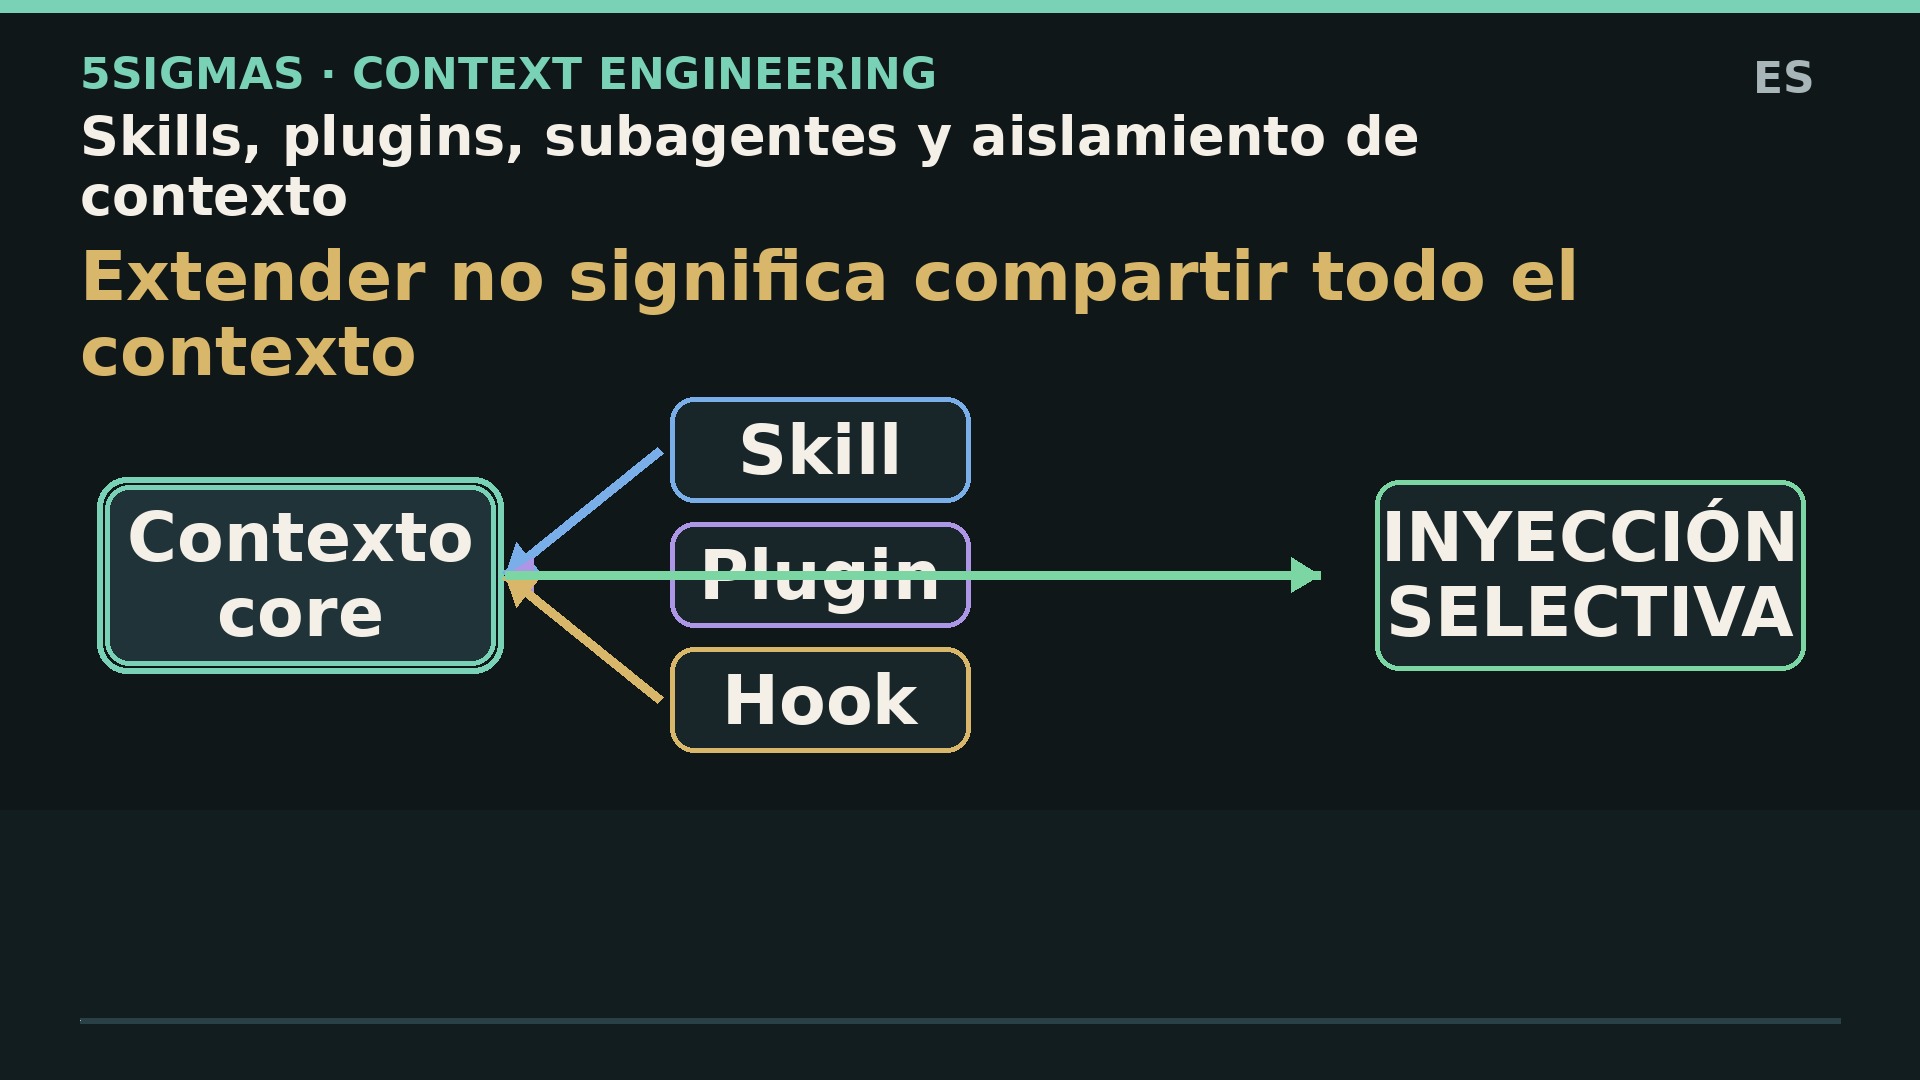 2:13
Extensiones, delegación y controles
La carga progresiva limita contexto. No aísla el proceso ni concede nuevas autorizaciones.
1. Cuatro primitives, cuatro preguntas distintas · 2. Una skill es una unidad de expertise reutilizable; no es una frontera de seguridad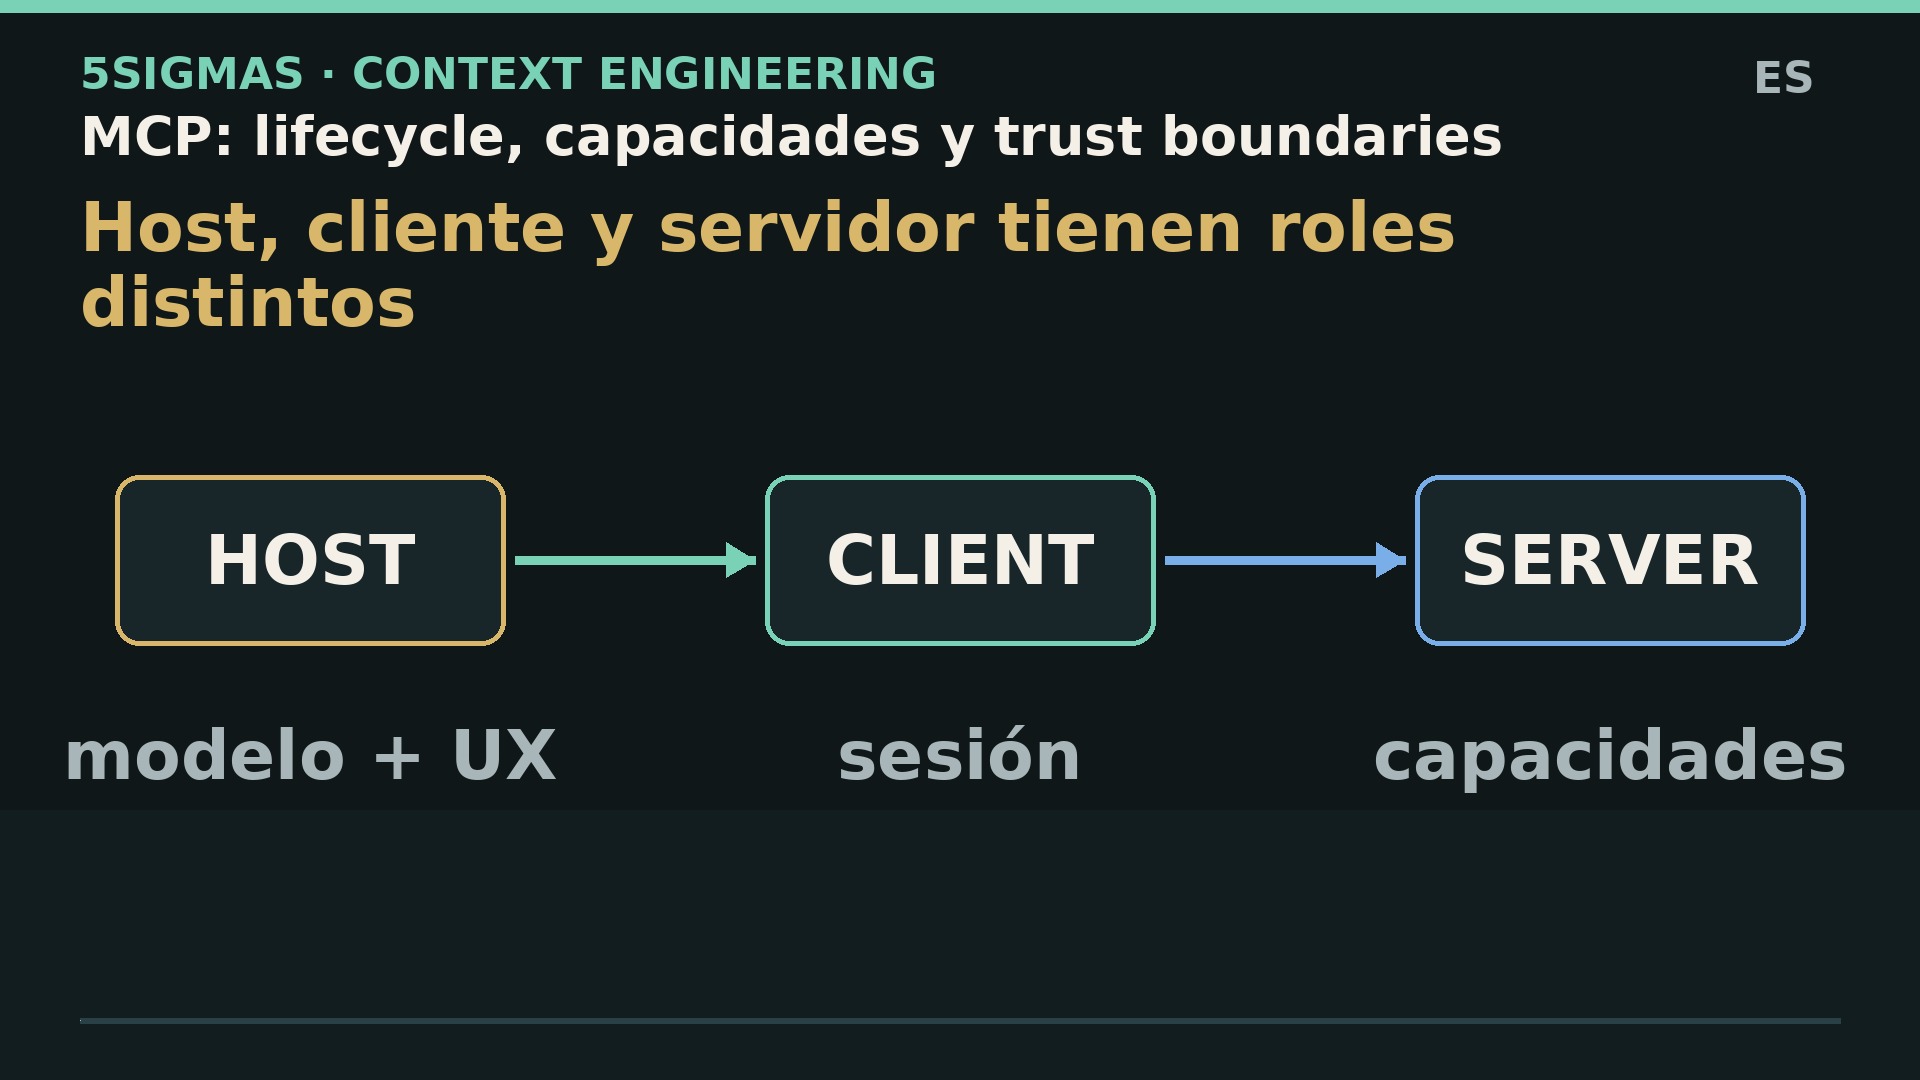 2:14
MCP: protocolo y confianza
Conectar dos servidores no autoriza que uno reciba los datos del otro.
1. Empieza por las responsabilidades: host, client y server no son sinónimos · Host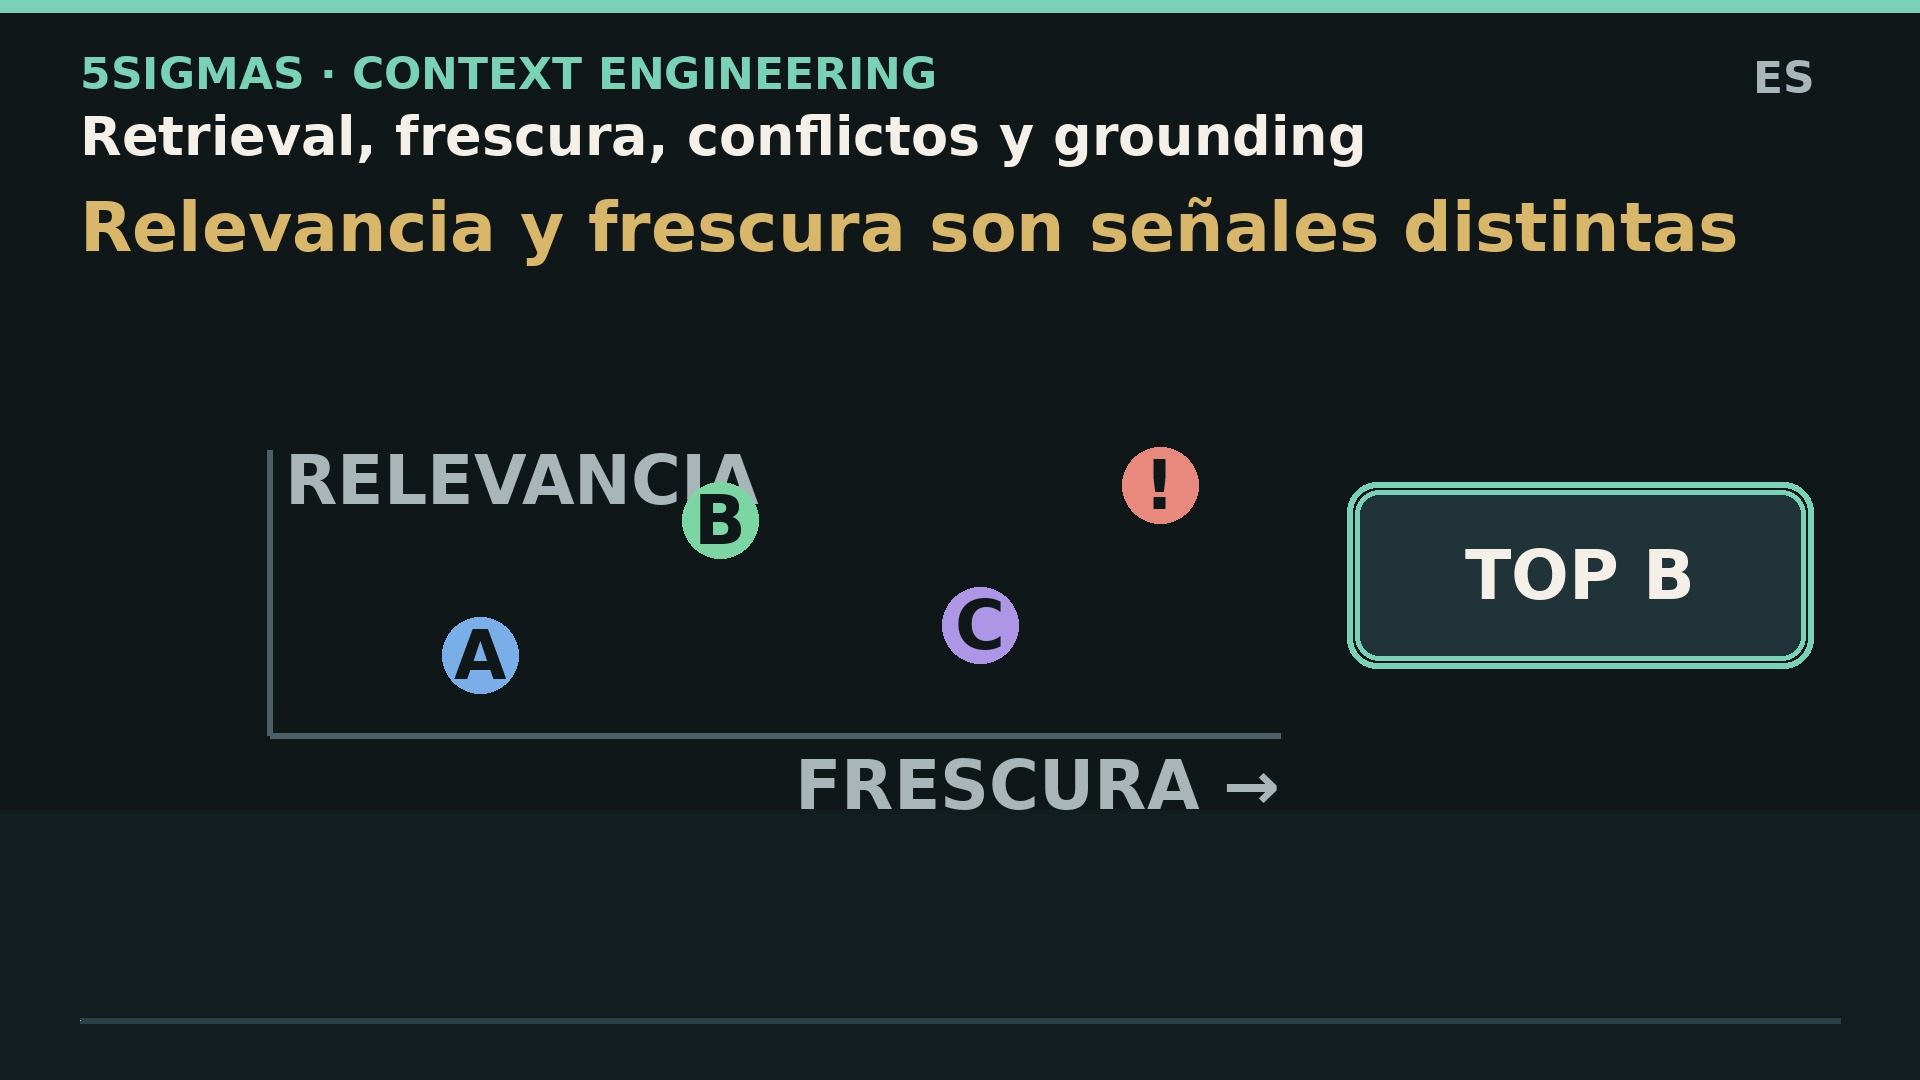 2:14
Recuperación y grounding
El assembler comprueba acceso, revisión y autoridad antes de utilizarlos juntos.
1. Retrieval no es ensamblado de contexto · 2. Léxico, semántico y estructurado resuelven problemas diferentes 2:09
Memoria y estado autoritativo
Un checkpoint también persiste, pero su contrato es reanudar la ejecución, no aprender una preferencia.
Working state: lo que la ejecución necesita ahora · Episodic memory: hechos situados en el tiempo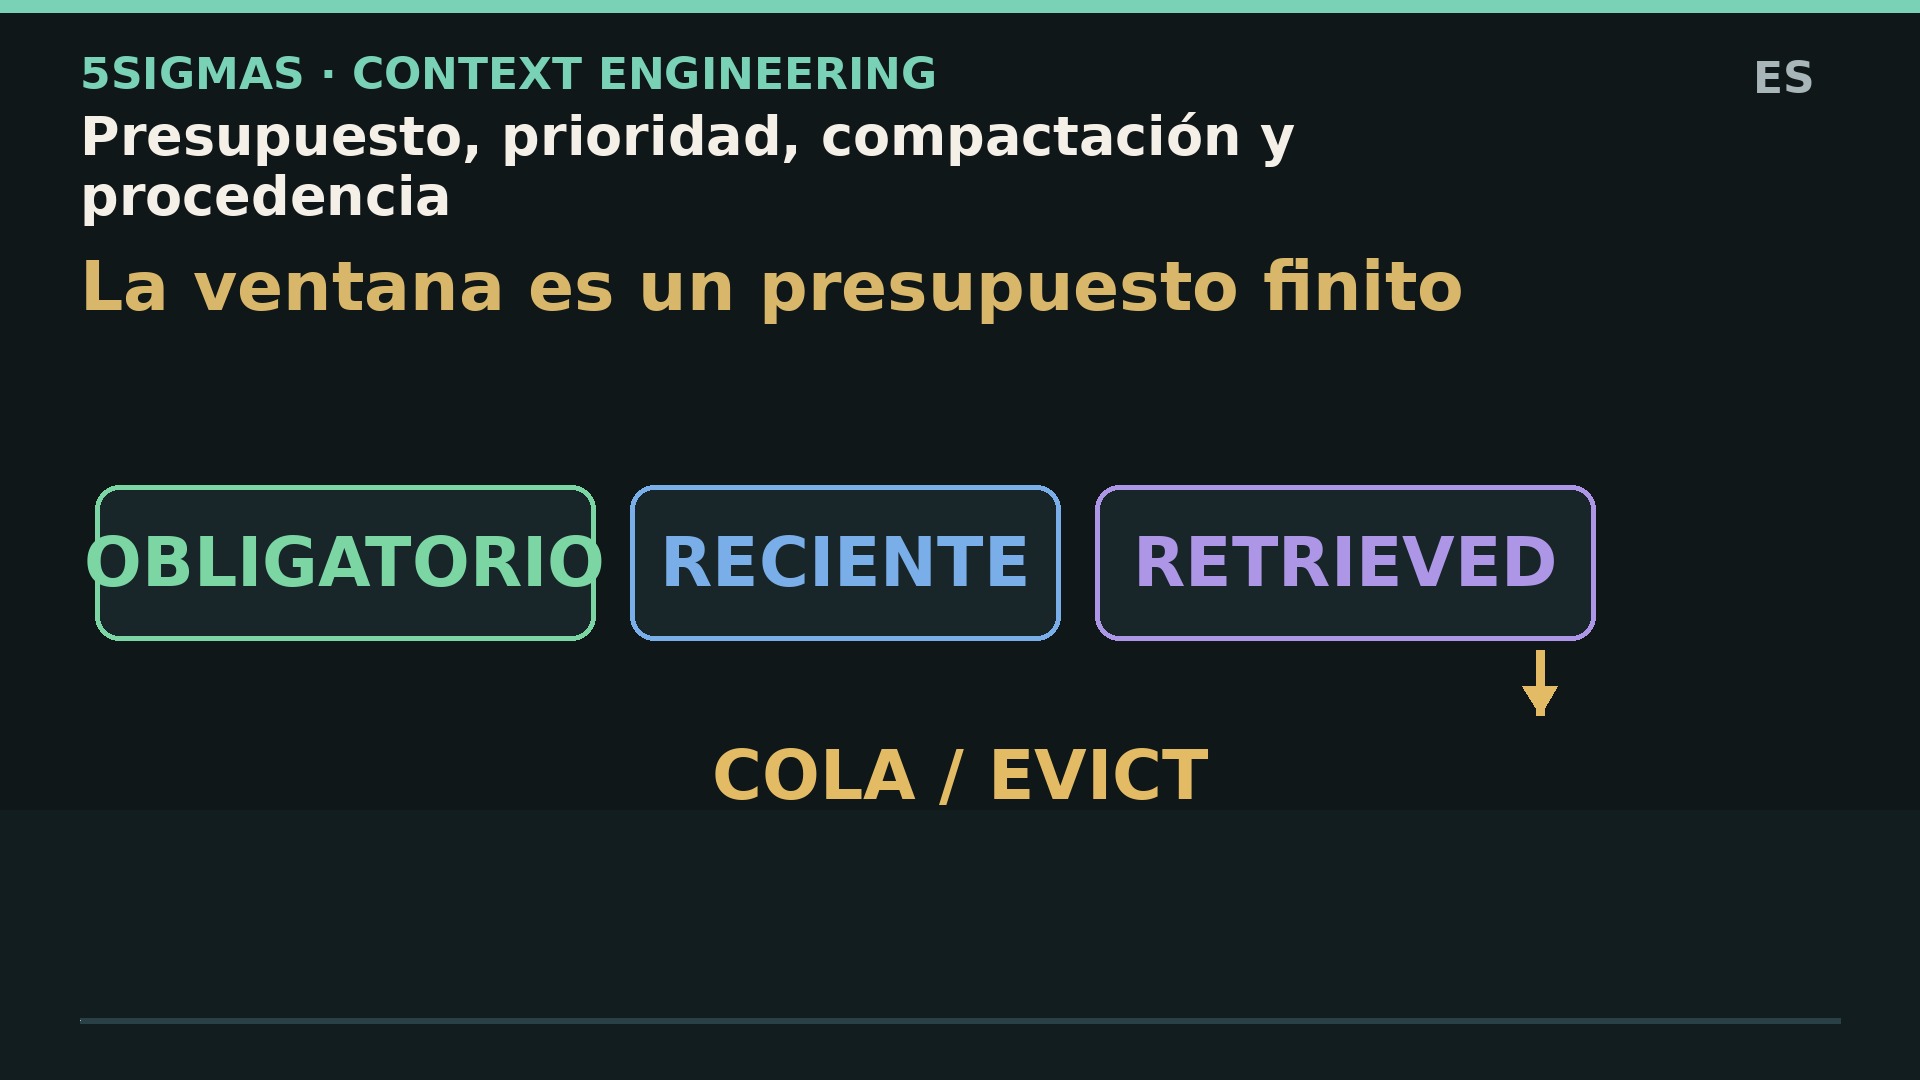 2:15
Presupuesto y procedencia
Quedan 48 mil para información dinámica. No es una propiedad universal del modelo.
El máximo de contexto no es tu presupuesto operativo · Un item de contexto necesita más que texto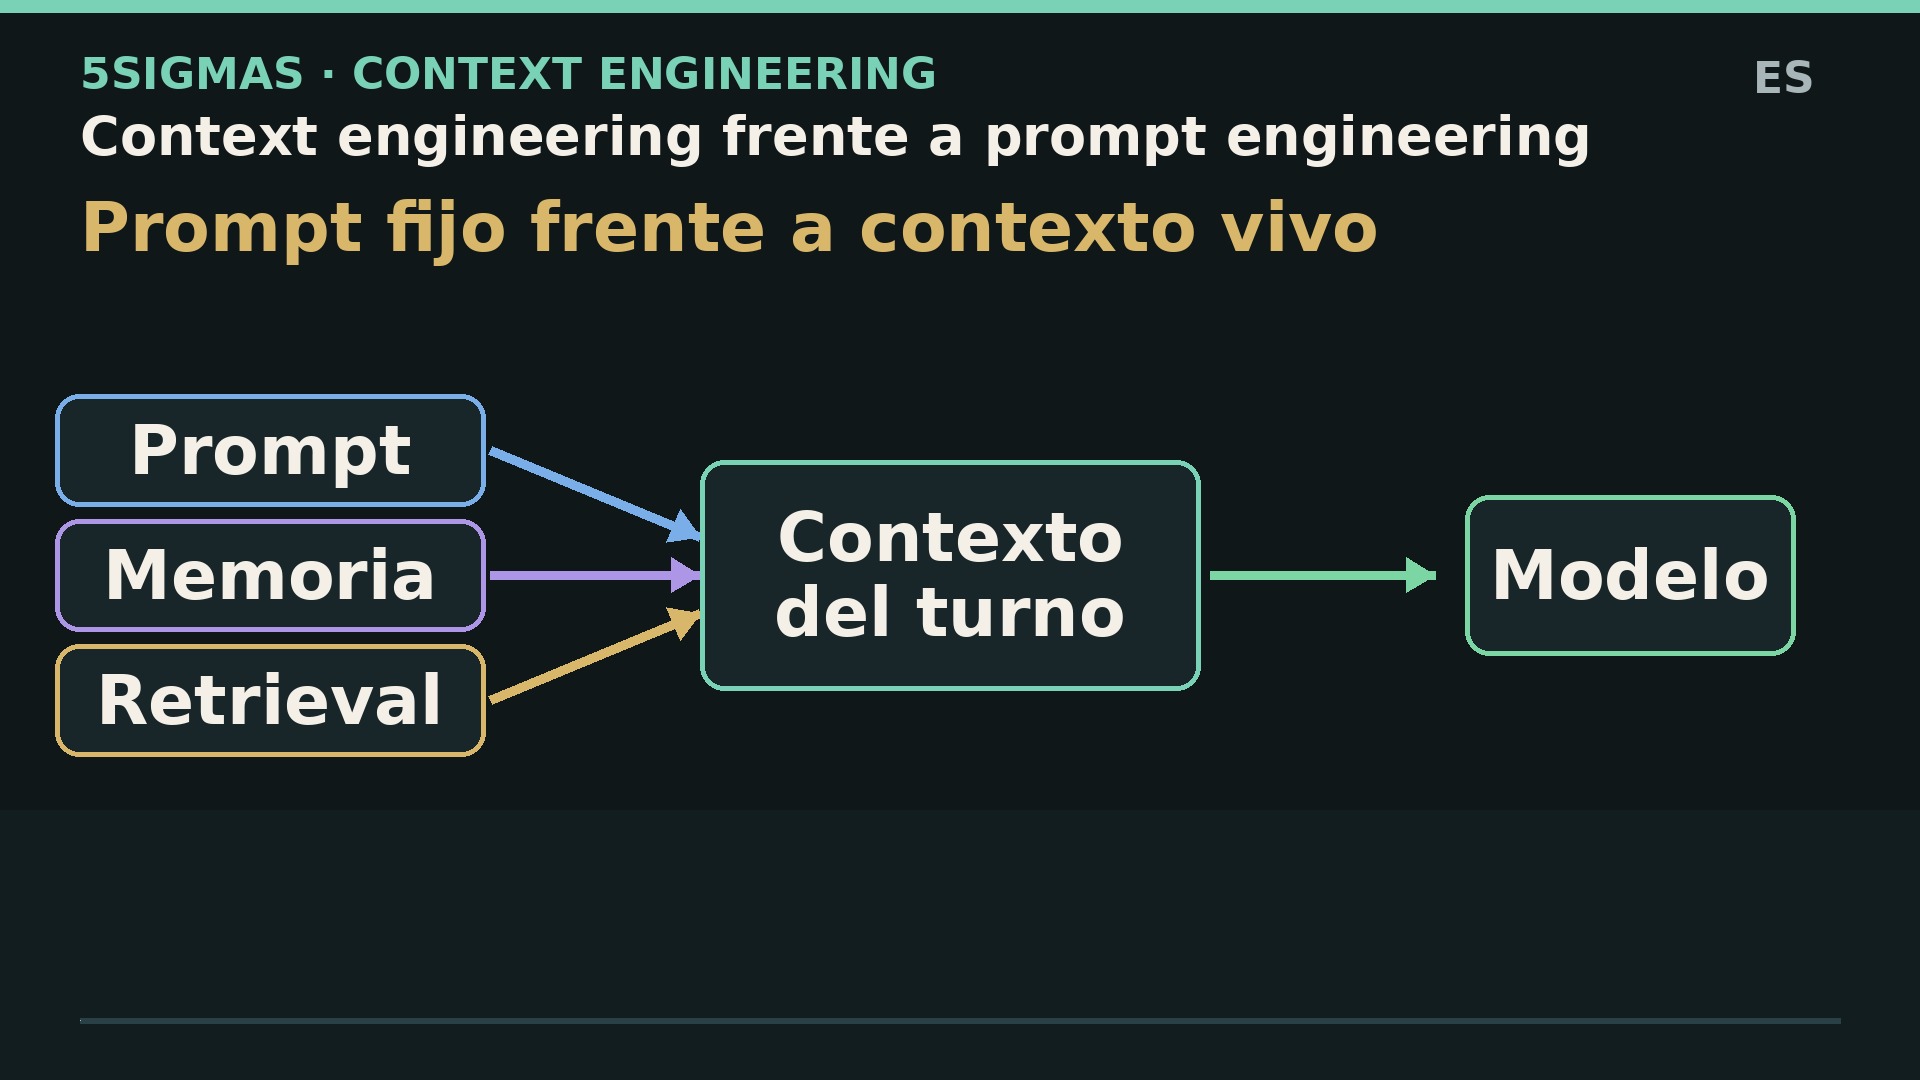 2:11
Qué entra al modelo
La decisión depende de esa entrada concreta, no de todo lo que existe en la aplicación.
Primero: qué significa aquí «contexto» · Prompt engineering es una parte del problema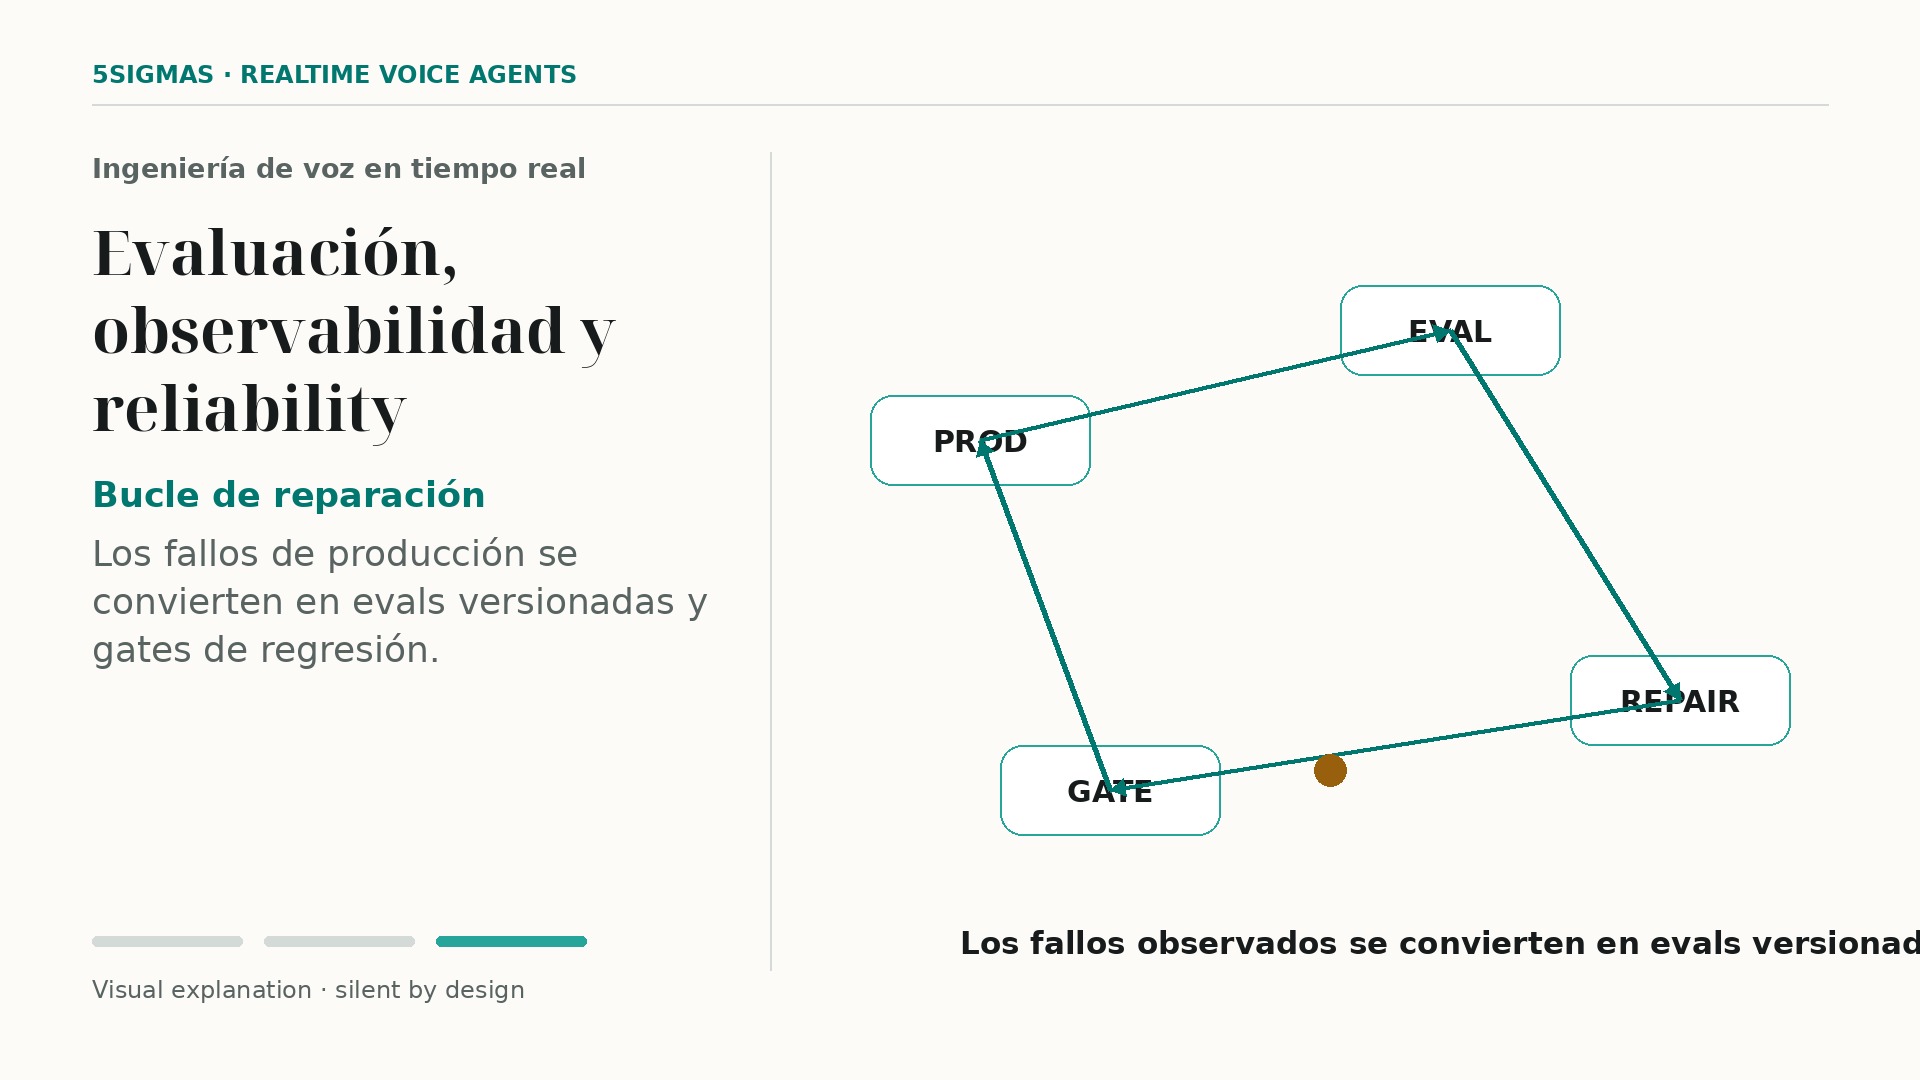 2:19
Evaluación y observabilidad
Une negocio, turno, media y runtime. La transcripción no demuestra el resultado completo.
Una transcripción no es la verdad del sistema · El objeto mínimo de análisis debe ser el turno lógico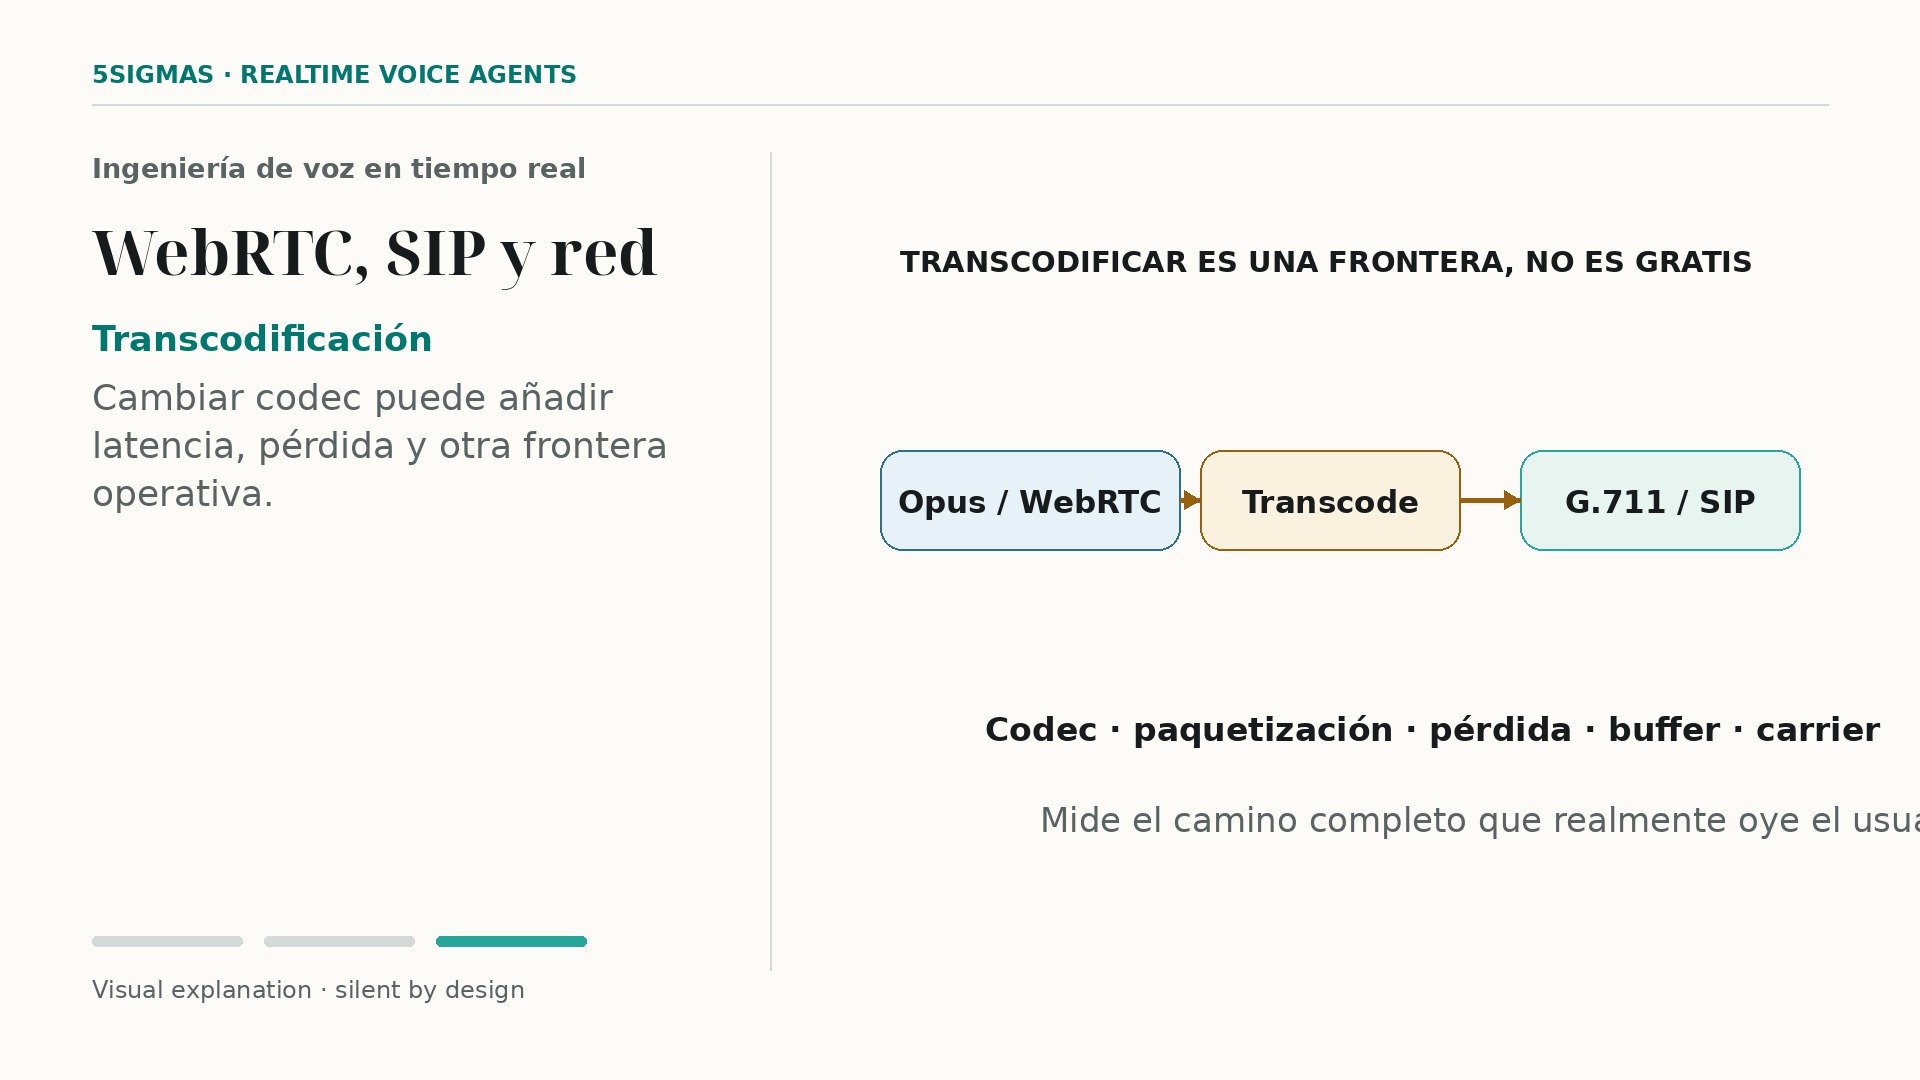 2:19
Media, red y telefonía
Comprueba cada ruta de media y su codec. No diagnostiques sólo con «conectado».
Empieza por dibujar el camino, no por elegir un acrónimo · WebRTC: la ruta elegida por ICE importa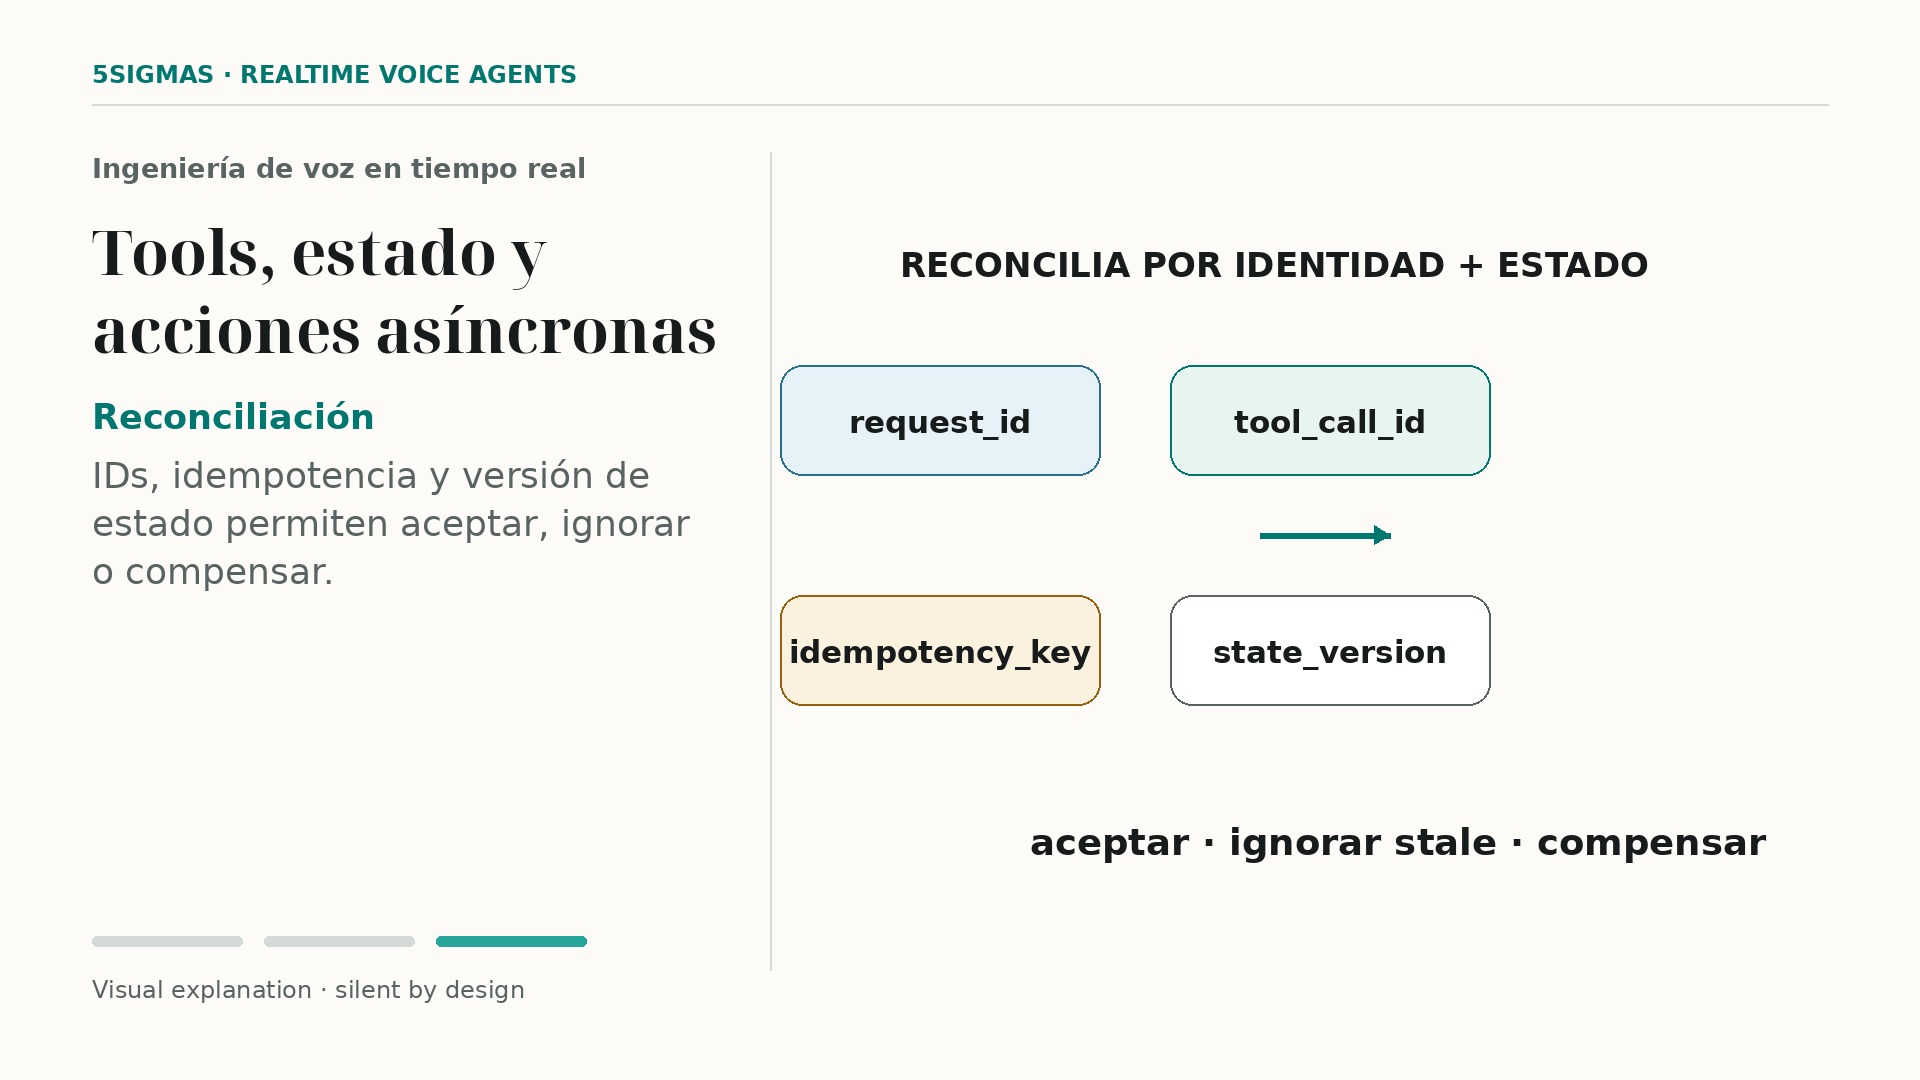 2:19
Tools y estado durable
La conversación comunica el resultado observado. Una frase no crea una reserva.
Una tool call no es el efecto externo · Separa cuatro tipos de estado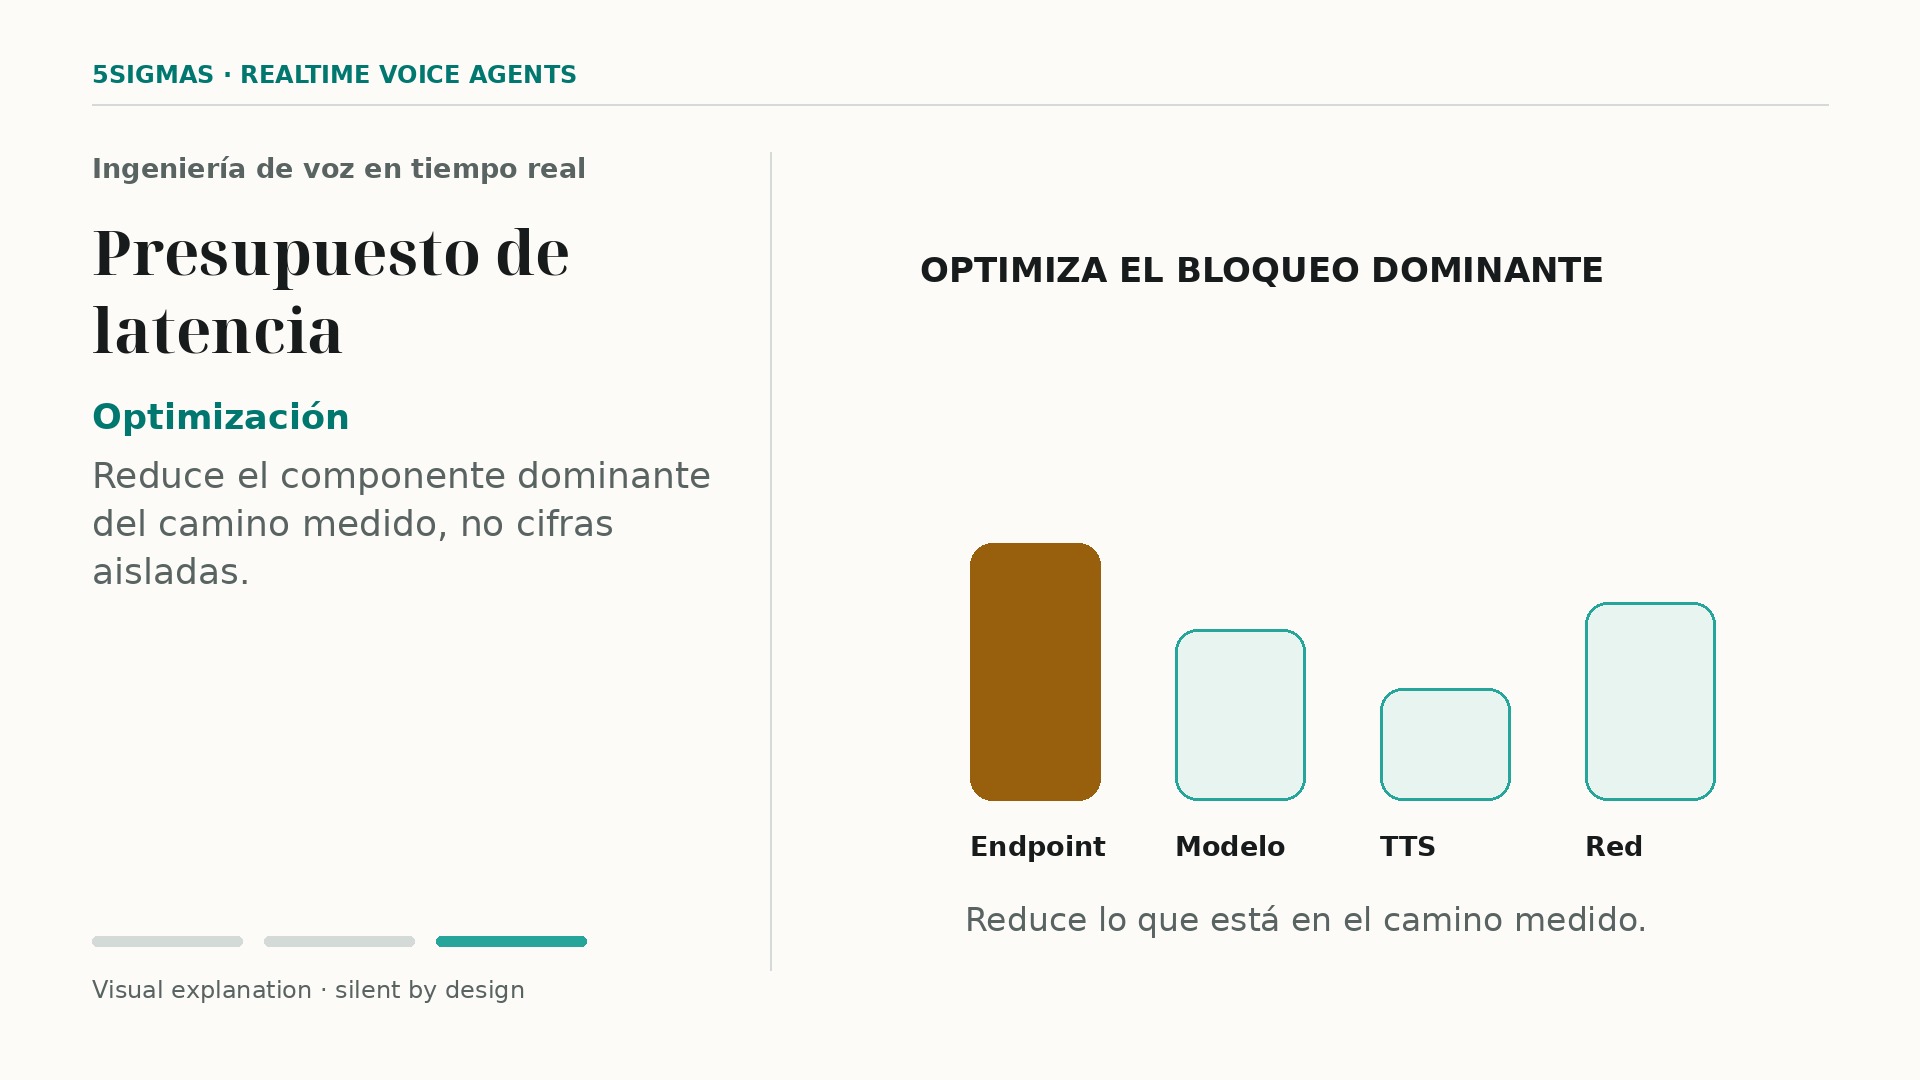 2:19
Presupuesto de latencia
Con el mismo reloj, la espera total es 300 más 480. No es el TTFT del modelo.
Una métrica de latencia necesita dos fronteras explícitas · El reloj también forma parte de la definición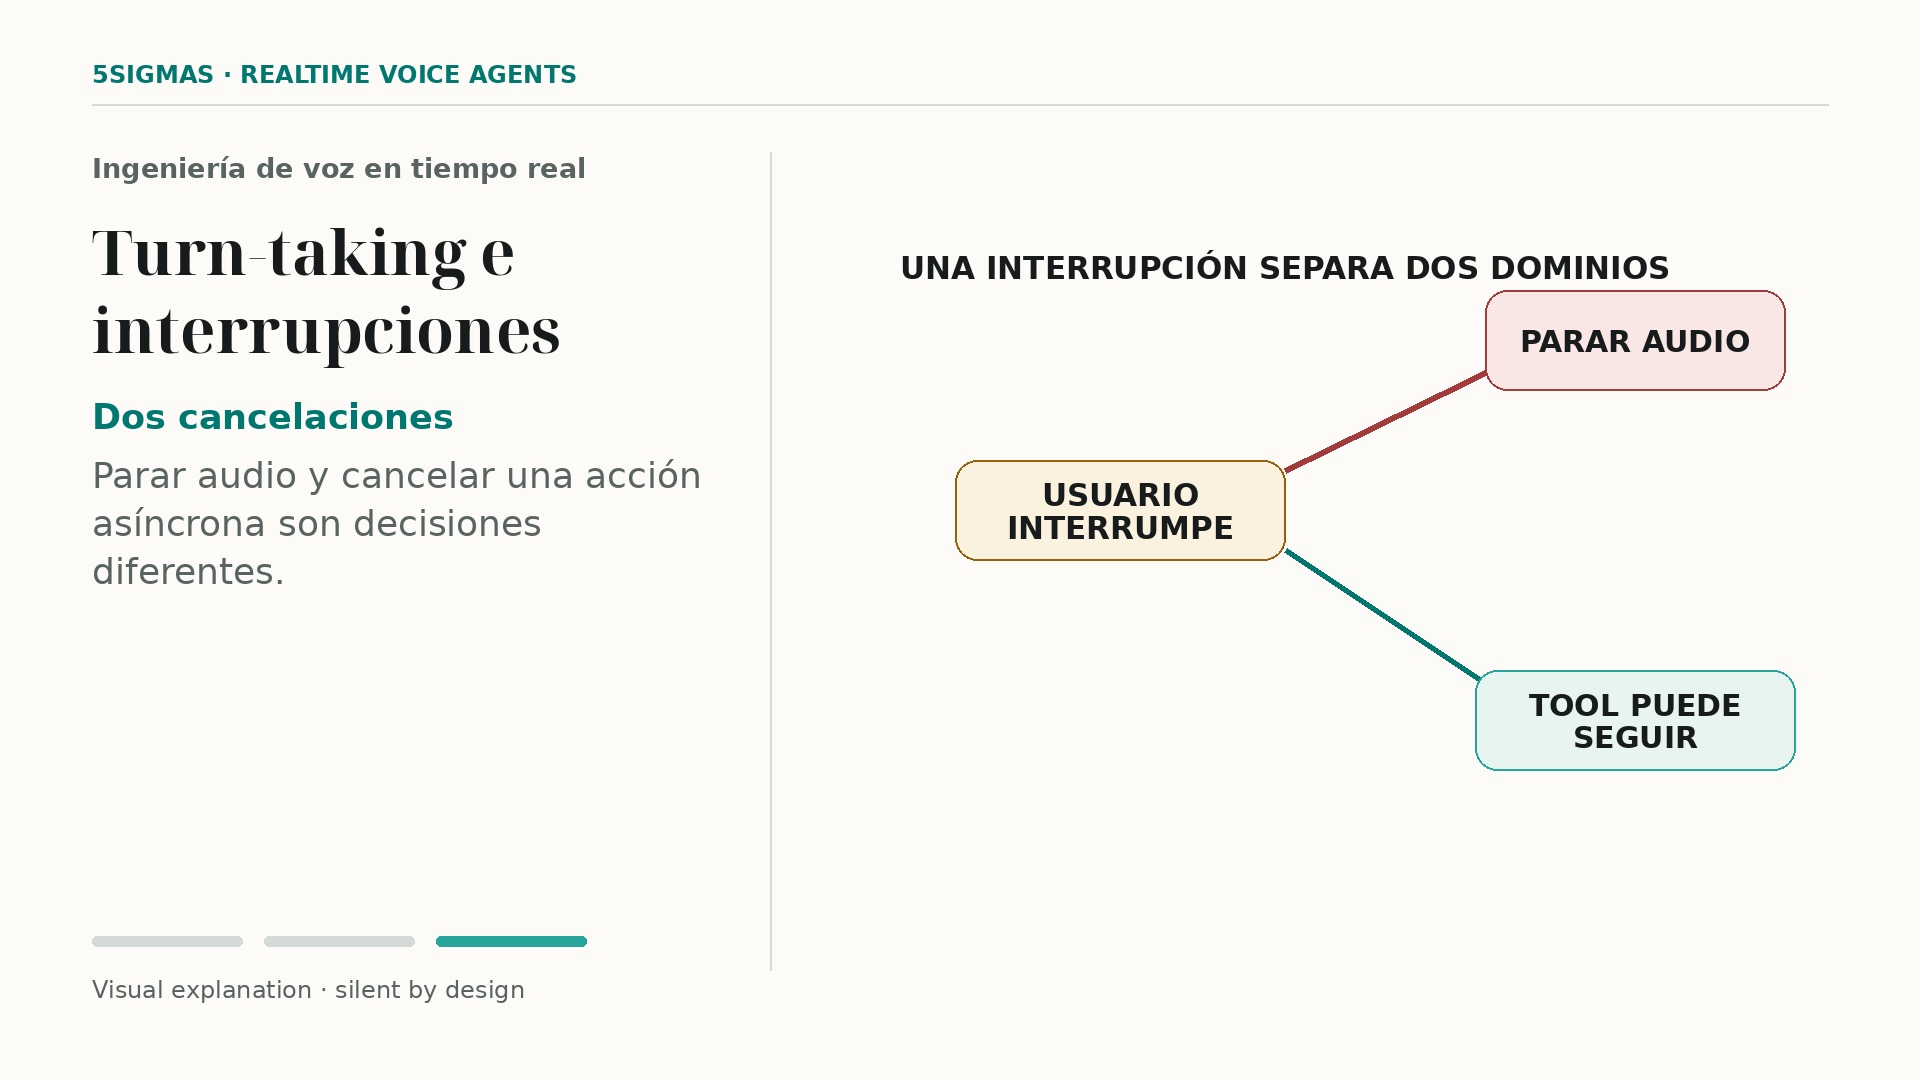 2:18
Turnos e interrupciones
VAD detecta actividad. El fin de turno necesita evidencia sobre la intención completa.
VAD responde «¿hay habla?», no «¿ha terminado la idea?» · Un timeout es una política, no una prueba semántica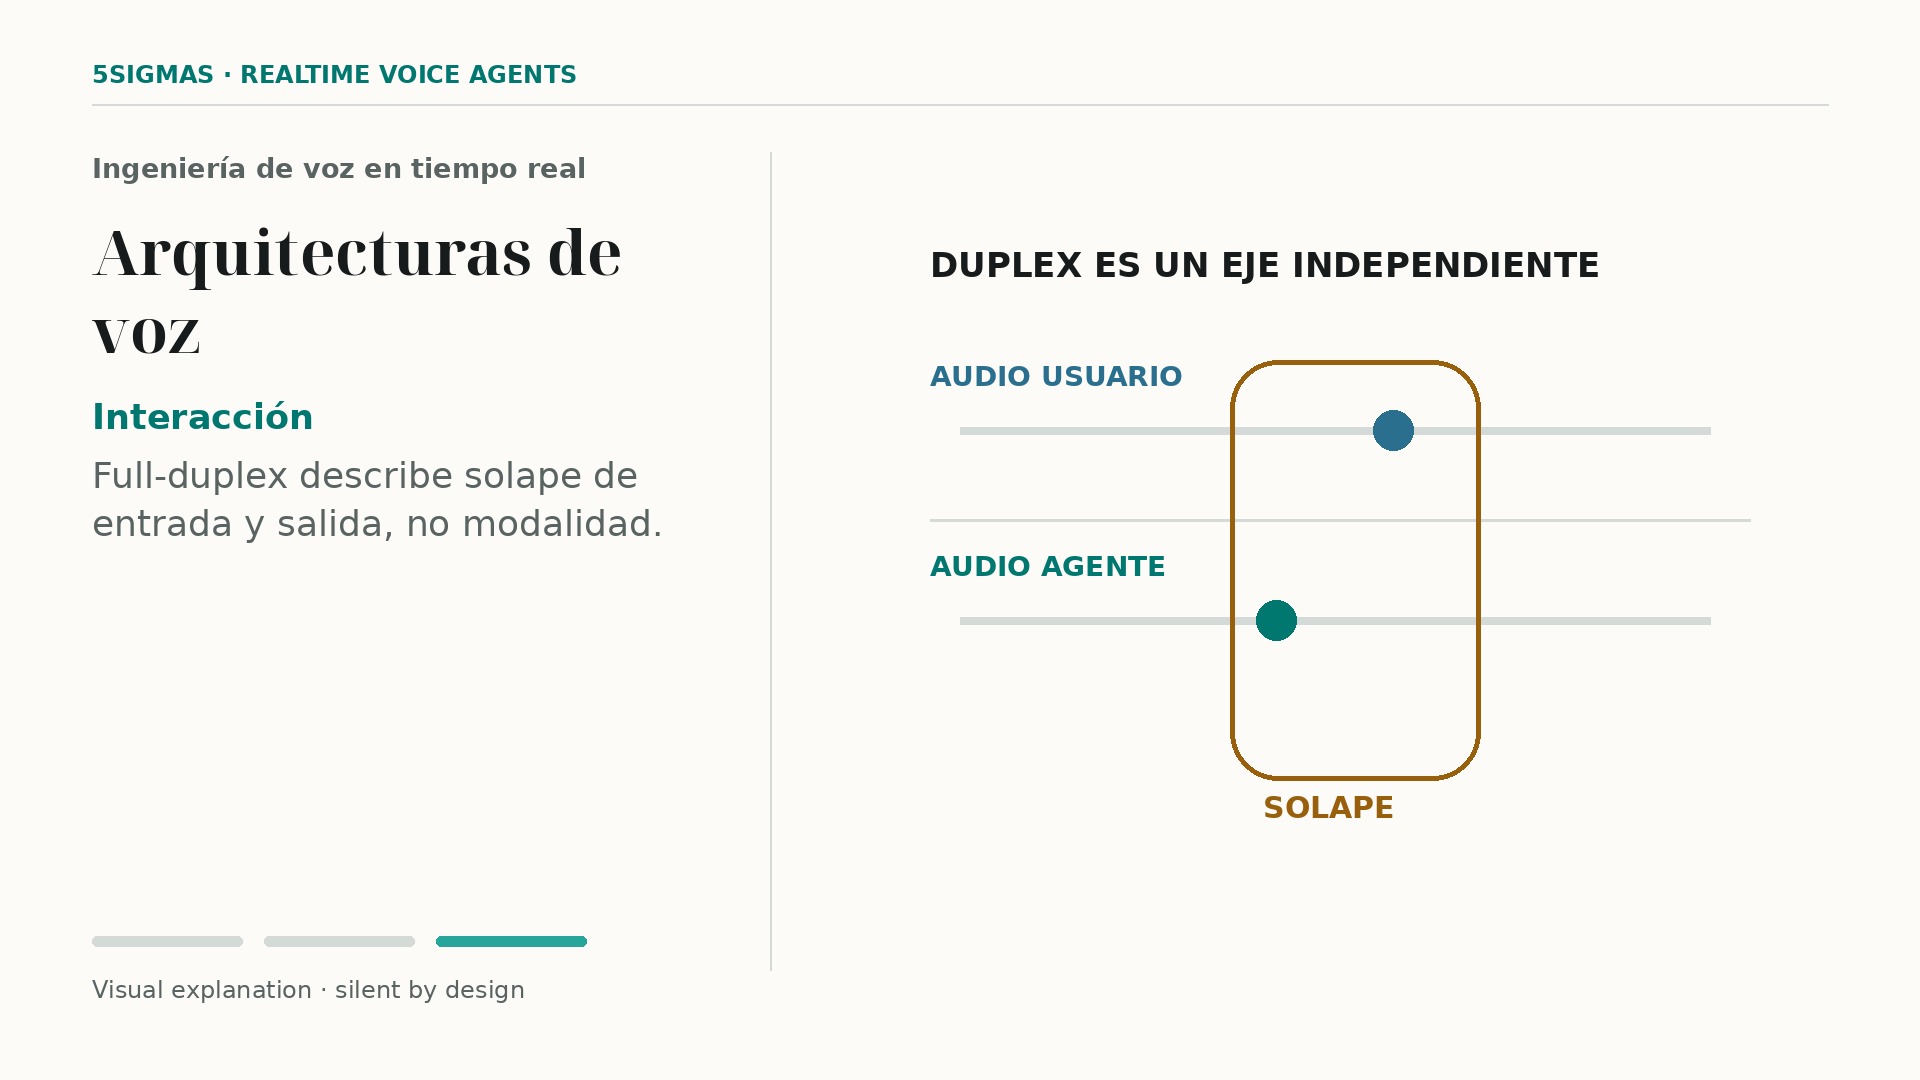 2:18
Arquitecturas de voz
El mismo turno atraviesa todas las etapas. El runtime debe coordinar sus resultados.
Tres arquitecturas de modalidad · 1. Full cascade: audio → STT → LLM → TTS → audio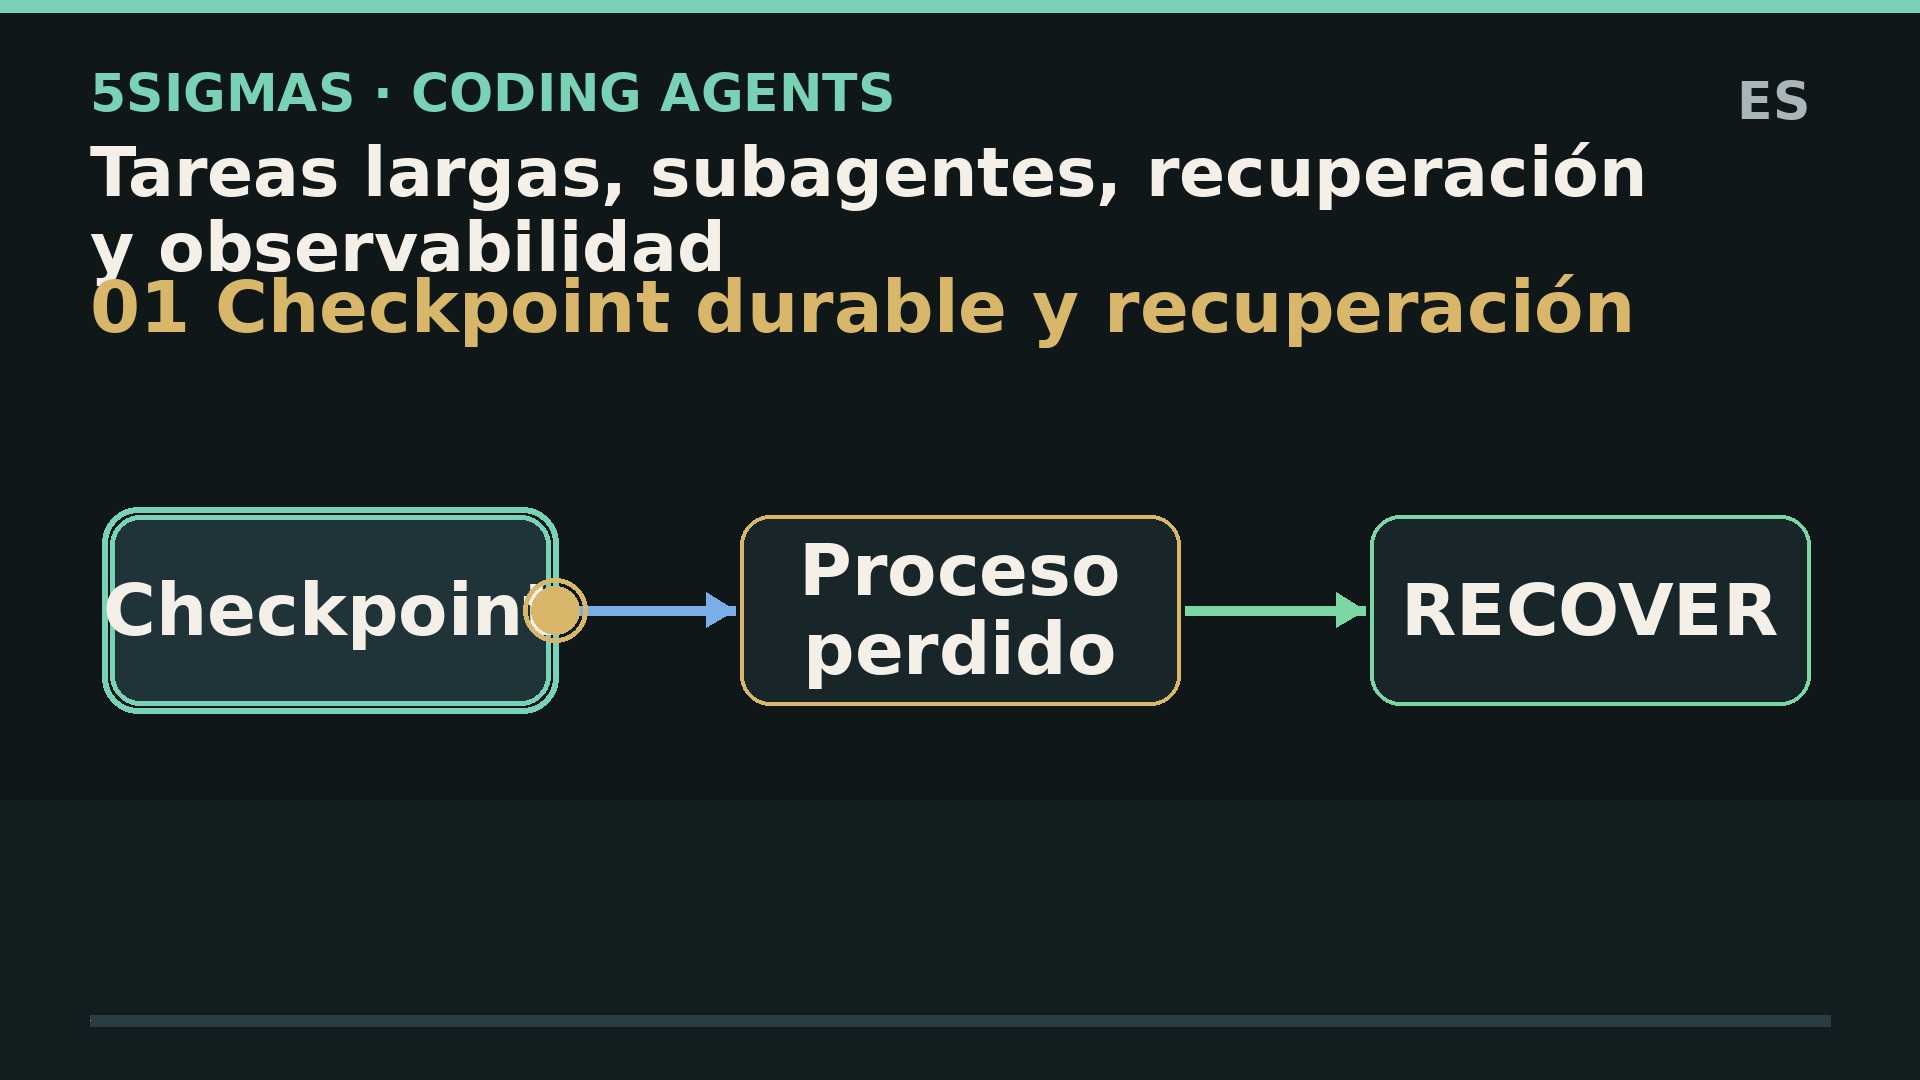 2:15
Tareas largas, recuperación e integración
La confirmación remota vincula T7 con R42 y se registra aparte. Un intento no sustituye a un resultado.
Una tarea larga es una máquina de estados durable, no una conversación infinita · «Memoria» no es un único objeto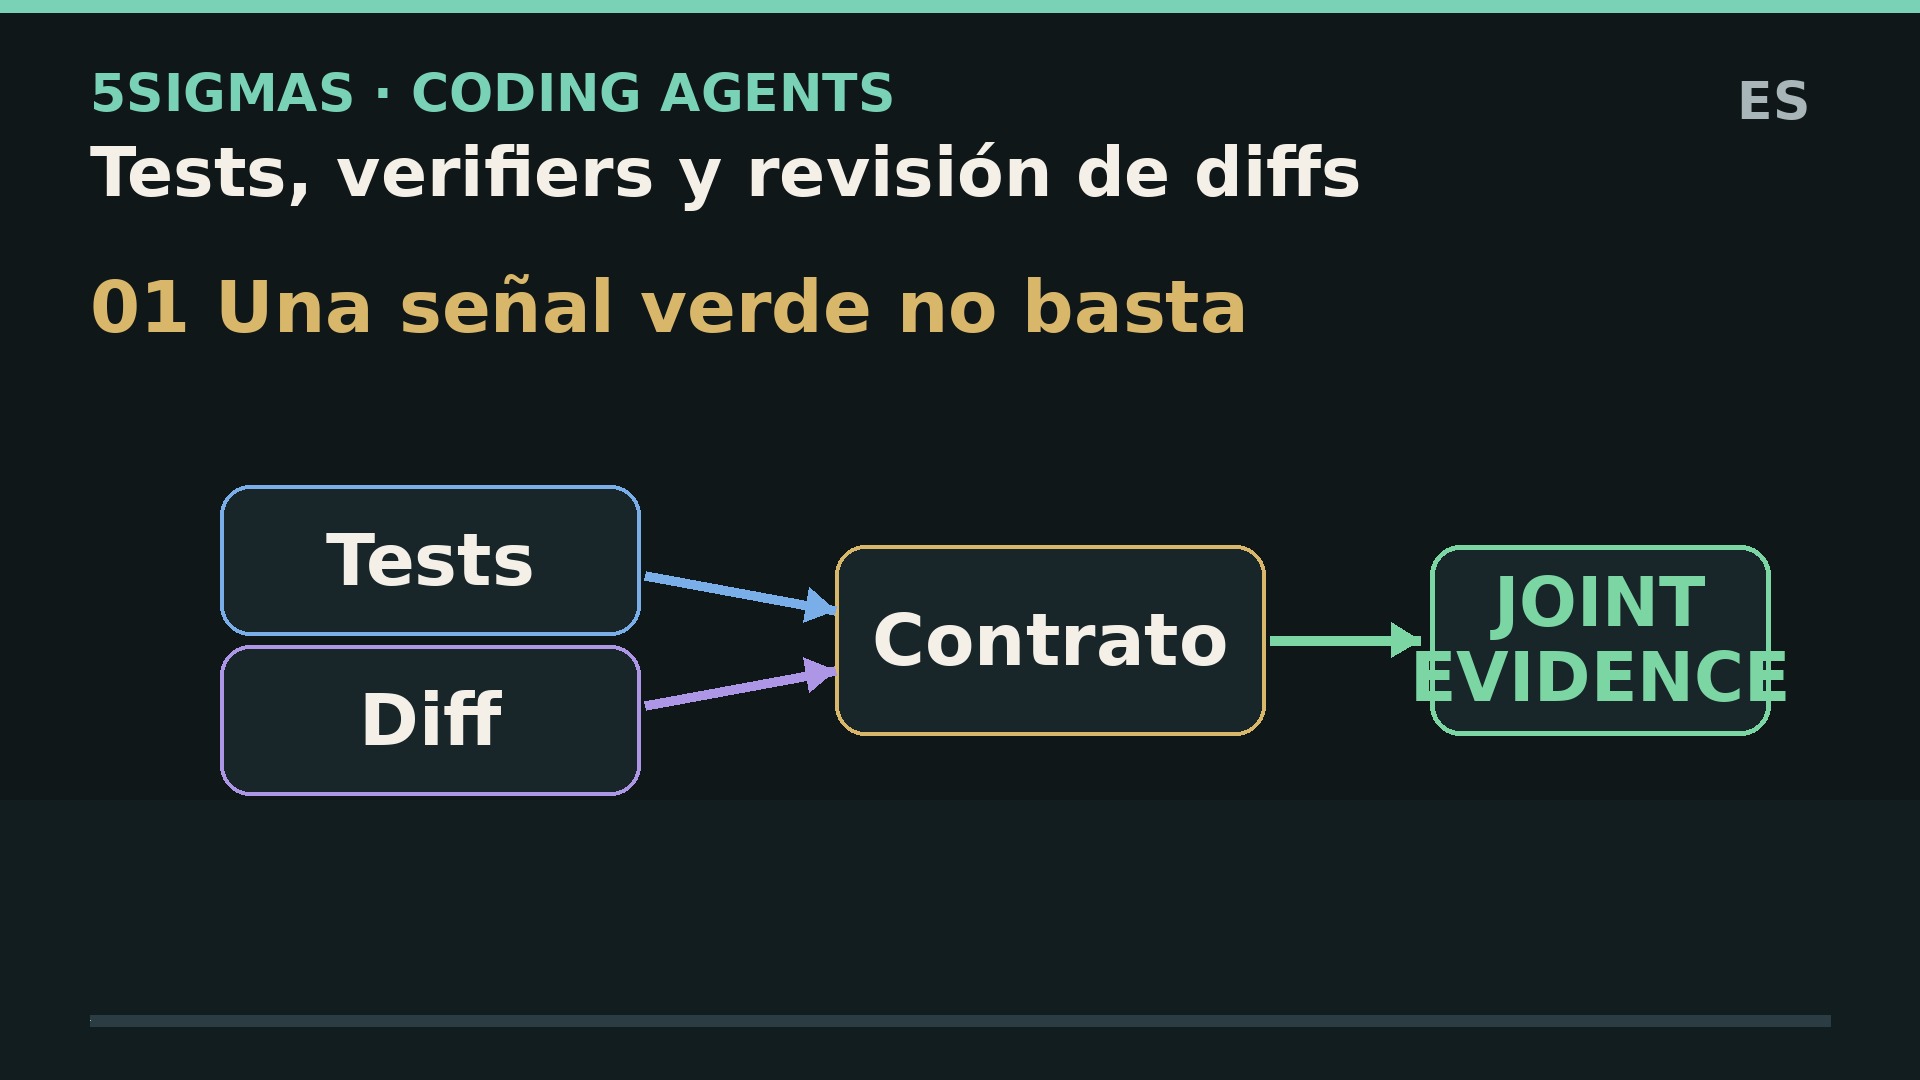 2:13
Tests, verificadores y condiciones de parada
La revisión del diff añade otra pregunta: qué cambió realmente y si estaba permitido.
Test, verifier, reviewer y stop condition no son sinónimos · «Los tests pasan» sólo tiene significado respecto a un contrato 2:12
Tools, permisos y límites de confianza
La lista de tools describe capacidad. La frontera efectiva decide qué efectos pueden ocurrir.
La pregunta correcta no es «¿qué tools tiene el agente?» · Tool availability y permission son controles diferentes 2:12
Specs, planes y checkpoints
Estas condiciones permiten rechazar una implementación que sólo cumple la mitad.
La petición no es todavía el contrato · Instrucciones persistentes y spec resuelven problemas diferentes 2:10
Contexto, workspace y aislamiento
Separar una copia no demuestra que esté confinada. Hay que comprobar ambas fronteras.
Cinco objetos que conviene nombrar por separado · 1. Repositorio y revisión base 2:10
El modelo y el harness
Sólo entonces existe un resultado real: salida, errores y código de retorno.
El modelo no posee el repositorio · 1. Modelo 2:14
Del incidente a la reparación
Después de la release, mide recurrencia y exposición durante la ventana acordada. Cierra el ciclo con evidencia de producción y una persona responsable.
Observabilidad y evaluación responden preguntas distintas · Primero conserva una identidad reproducible del sistema 2:14
Evidencia antes de ampliar
Una violación bloquea; datos insuficientes mantienen la pausa. El protocolo depende del cambio y su riesgo: no exige siempre todas las etapas.
Antes de exponer tráfico, fija la unidad de cambio · Shadow: primero observa el candidato sin darle autoridad sobre la respuesta 2:16
El resultado y el camino
Una violación dura bloquea aunque otras métricas mejoren. Guarda la trayectoria y el motivo del veredicto para poder reproducirlo.
Una trayectoria es una secuencia de transiciones, no una lista de tool names · Empieza por el outcome: ¿la tarea terminó realmente resuelta? 2:14
Cómo evaluar al evaluador
Congela la versión del juez antes de comprobar un set separado. Acepta, limita o rechaza su uso según el riesgo y la evidencia.
Primero define qué significa «calibrar» · Elige primero el tipo de grader más estrecho que resuelva la pregunta 2:14
Casos que ponen a prueba
Cambiar una etiqueta o un grader puede cambiar el score sin mejorar el modelo. Publica una nueva versión; no reescribas el resultado anterior en silencio.
El objeto correcto: una versión del eval, no «el dataset» · La unidad mínima debe poder auditarse 2:12
Qué estamos evaluando
Una prueba amplia comprueba la tarea, las políticas y los efectos reales. Conserva versiones, casos y protocolo para poder comparar.
La evaluación empieza definiendo el objeto, no la métrica · Nivel 1 — Evaluar el modelo 1:30
Controles de producción
Cómo mínimo privilegio, autorización independiente, kill paths, observabilidad y gates ligados a evidencia limitan el daño cuando el modelo falla.
Separar la lectura de documentos y las acciones · Dar a cada herramienta solo los permisos que necesita 1:30
Red-teaming
Cómo probar la cadena causal completa desde una entrada adversaria hasta autorización, efecto externo, recuperación y una regresión reproducible de release.
El threat model viene antes que el benchmark · Separar lo que el modelo sabe hacer de lo que el sistema ejecuta 1:30
Envenenamiento
Cómo una entrada no confiable puede convertirse en memoria persistente, reaparecer en una decisión futura y sobrevivir a un borrado incompleto mediante estado derivado.
Guardar un dato no lo convierte en verdad · La memoria persistente ya es una superficie de ataque medible 1:30
Jailbreaks
Cómo los intentos repetidos y adaptativos cambian la superficie de ataque y por qué la autorización y los límites de intentos siguen importando después de una negativa.
Rechazar una petición no crea una frontera perfecta · Probar muchas variantes cambia el coste del ataque 1:30
Seguridad en IA
Cómo una entrada no confiable puede influir en un sistema con IA y qué fronteras de autorización limitan que esa influencia se convierta en una acción.
1. Una orden escondida en un documento puede cambiar lo que hace el sistema · 2. Pedir al modelo que ignore sus límites 2:18
De la demo a producción
Reserva la decisión del modelo para el tramo que depende de la situación. Mantén límites, verificación y una alternativa operable alrededor de ese tramo.
Presupuestos antes que promesas · Retries, idempotencia y fallos terminales 2:12
Seguridad y autorización
Las restricciones de herramientas deben seguir limitando su ejecución. Combina controles y auditoría; este ejemplo no garantiza inmunidad.
Prompt injection directa e indirecta · La autorización debe vivir fuera del prompt 2:14
Cómo evaluar un agente
Separa los permisos de la tarea de los recursos del verificador. Registra los intentos fuera de alcance e inspecciona la trayectoria.
La unidad de evaluación es una tarea · Cuatro dimensiones que conviene medir 2:14
Tools, memoria y estado
Conserva su procedencia y comprueba la evidencia antes de usarlo. La memoria necesita reglas de corrección, caducidad y borrado.
El bucle mínimo · Tool calling: del texto a un contrato 2:12
Qué es un agente
La respuesta de la herramienta identifica el borrador D4 y su estado. Comprueba esa evidencia y detente sin ejecutar acciones adicionales.
Una escala de autonomía · 1. Respuesta directa 2:12
Agentes de IA
La conversación puede continuar mientras la herramienta trabaja. Sólo el resultado verificado permite comunicar que la tarea terminó.
1. Qué es un agente y qué no lo es · 2. La anatomía de un agente 2:16
La huella real de un datacenter
Reutilizar componentes puede prolongar su servicio sin eliminar todos los impactos. Compara alternativas por el mismo trabajo útil y el ciclo completo.
1. La comparación que calibra la conversación · 2. Agua: el retiro, el consumo y la tecnología que lo determina 2:12
Qué significa computar en órbita
Incluye coordinación de enlaces, gestión de fallos y retirada al final de vida. La propuesta debe explicar quién opera, quién responde y cómo se cierra.
1. Qué significa procesar datos en órbita · Procesamiento de datos de observación 2:18
Energía, calor y conectividad
La corrección de errores y la redundancia ayudan dentro de sus límites. Un fallo no recuperable exige otro plan; el mantenimiento no es gratuito.
1. Por qué el frío del espacio no implica enfriar gratis · La escala real de los radiadores 2:14
Por qué ahora
Cambia un supuesto y vuelve a calcular el presupuesto. No presentes el escenario optimista como un precio ya conseguido.
1. La explosión de la demanda de cómputo · 2. Los cuellos de botella en tierra 2:12
Datacenters en el espacio
Añade energía, refrigeración, enlaces, lanzamiento y fin de vida. Una ventaja local no demuestra que el conjunto sea mejor.
1. Por qué ahora · 2. Energía, calor y conectividad 1:30
Prompt injection
Cómo una orden escondida en un documento puede entrar en un sistema con IA y qué controles separan la lectura de una acción.
1. El problema empieza cuando un documento llega al modelo · 2. La orden puede aparecer en una búsqueda de documentos 0:20
Agente Reactivo, Proactivo y Tool calls
Un recorrido técnico por Reactive / Proactive Agent y por el contrato conversacional que encapsula: respuesta inmediata, trabajo asíncrono y cierre diferido.
El problema no es la tool, es el tiempo · El primer turno acepta trabajo, no promete resultados 2:01
Riesgos — overthinking, coste, ataques y alineamiento
Overthinking, prompt injection y hijacking de agente en modelos razonadores con herramientas. Criterios para acotar el riesgo en producción.
1. Sobrepensamiento: cuando más razonamiento deteriora la respuesta · 2. Calidad vs coste vs latencia en producto real 1:55
Tiempo físico — latencia, streaming e interacción humana
TTFT, streaming y umbrales de latencia percibida en modelos razonadores. RouteLLM, patrones de diseño y gestión de coste de sesión en producción.
1. Umbrales de latencia percibida · Enrutamiento dinámico: RouteLLM 2:09
Test-Time Compute
Test-time compute como segunda ley de escala. Las tres palancas (más pasos, más candidatos, más estructura) y su perfil de calidad, coste y latencia en modelos razonadores.
1. Qué es test-time compute y por qué importa · 2. Las tres palancas 1:48
Cómo se ven los fallos de los modelos razonadores
Sycophancy, shortcut learning, specification gaming y fallos en cadena: los tipos de fallo de los modelos razonadores, cómo detectarlos y mitigarlos.
1. Tipos de fallos · 1.1 Atajos (shortcut learning) 1:22
Qué significa razonar en un LLM
Qué significa razonar para un modelo de lenguaje, qué aportan o1 y DeepSeek R1, y por qué evaluar razonamiento exige mirar pasos, coste y fallos.
1. Qué significa "razonar" para un humano · 2. Qué pueden hacer los LLMs que se parece al razonamiento 1:15
Modelos razonadores — test-time compute, cadenas de pensamiento y fallos sistemáticos
Cinco capítulos sobre cómo razonan los LLMs: test-time compute, fallos, latencia, coste y riesgos cuando usan herramientas.
1. Qué es “razonar” para un LLM · 2. Cómo se ven los fallos de estos sistemasNo hay vídeos que coincidan con la búsqueda.